KI-Modelle benötigen in der Regel eine hohe Rechenleistung, was insbesondere Anwenderunternehmen aus dem Embedded-Segment vor große Herausforderungen stellt. Ein namhafter Sensorhersteller wollte dennoch Deep-Learning-Modelle direkt auf seinen kompakten Sensoren ausführen, um Deep-Learning-basierte Bildverarbeitungsfunktionen ohne zusätzliche Hardware zu realisieren. Bisherige Ansätze stießen dabei an ihre Grenzen: Herkömmliche CPUs in Embedded-Systemen sind oft zu langsam für anspruchsvolle Bildanalysen in Echtzeit, während leistungsstarke GPUs aufgrund ihres hohen Stromverbrauchs, Wärmeentwicklung und Platzbedarfs für kompakte Sensorgehäuse ungeeignet sind. Zudem forderte die Anwendung eine hohe Flexibilität, da die Bedingungen in der industriellen Praxis häufig schwanken: So kann sich die Beleuchtung ändern oder neue Produktvarianten hinzukommen. Ein starres Deep-Learning-Modell müsste in solchen Fällen aufwändig auf externen Workstations neu trainiert werden, was zu kostspieligen Stillstandzeiten führt. Der Sensorhersteller suchte daher nach einer performanten und energieeffizienten Lösung, die zudem eine einfache Anpassung der KI-Modelle direkt auf dem Gerät ermöglicht.
NPUs: spezialisierte Kraftpakete von Qualcomm
In diesem Pilotprojekt spielen die Neural Processing Units (NPUs) von Qualcomm eine entscheidende Rolle bei der Umsetzung leistungsstarker KI auf kompakten eingebetteten Geräten. Im Gegensatz zu CPUs oder GPUs sind NPUs speziell darauf ausgelegt, die Deep-Learning-Inferenz zu beschleunigen, wie sie z.B. in Machine Vision Anwendungen zum Einsatz kommt. Qualcomm bringt dabei seine Erfahrung aus dem Mobilfunkbereich ein: So müssen Smartphone-Prozessoren eine hohe Rechenleistung bei geringer Leistungsaufnahme und geringer Wärmeentwicklung bieten. Die gleichen Eigenschaften sind für kompakte Industriesensoren unerlässlich, die ohne aktive Kühlung KI-Inferenz in Echtzeit durchführen sollen. Ein weiterer Vorteil für die industrielle Anwendung ist die langfristige Verfügbarkeit der Hardware: Dadurch können Embedded-Systeme über viele Jahre hinweg betrieben und gewartet werden, ohne dass kurzfristige Hardwarewechsel erforderlich werden. OptoMedias ultrakompaktes Mini SFF bringt zuverlässige, schnelle Glasfaserverbindungen in Industriekameras der nächsten Generation. ‣ weiterlesen
Fiber Mini SFF für GigE Vision
Halcon-Schnittstelle für GPU-/NPU-Zugriff
Damit sich die Rechenleistung moderner KI-Beschleuniger effizient für Machine Vision nutzen lässt, bedarf es einer geeigneten Software-Anbindung. MVTec hat hierfür die ONNX Runtime (Open Neural Network Exchange) in seine Vision-Software Halcon integriert. ONNX fungiert als generischer Standard für KI-Modelle. In Verbindung mit der ONNX Runtime können Anwender ihre Modelle flexibel auf unterschiedlichen Zielplattformen ausführen: von der CPU über die GPU bis hin zu spezialisierten KI-Beschleunigern wie den NPUs von Qualcomm. Für den Sensorhersteller bedeutet dies ein hohes Maß an Investitionssicherheit: Die Software-Applikation kann weitgehend unverändert bleiben, auch wenn sich die zugrunde liegende Hardware ändert. Um die Leistungsfähigkeit der Qualcomm NPU effizient zu nutzen, kommt ein spezieller Workflow zum Einsatz: Während Deep-Learning-Modelle üblicherweise mit hoher Präzision (Float32) trainiert werden, können NPUs Modelle häufig effizienter mit 8Bit-Ganzzahlen (Int8) ausführen. Daher wird das Modell im Rahmen einer Quantisierung für die Int8-Ausführung optimiert, wodurch sich die Ausführungsgeschwindigkeit bei gleichzeitig hoher Genauigkeit deutlich steigern lässt.
Performance-Boost um Faktor 100
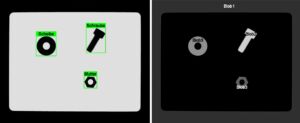
Ein Pilotprojekt untersuchte die Leistungsfähigkeit einer Qualcomm NPU in Kombination mit der Vision-Software Halcon auf einem Embedded-Gerät des Sensorherstellers. Die Ergebnisse fielen deutlich aus: In einer typischen Embedded-Anwendung zur Qualitätskontrolle konnte die Verarbeitungszeit erheblich reduziert werden. Während die Ausführung desselben Algorithmus auf einer herkömmlichen Embedded-CPU rund 300ms benötigte, wurde die Aufgabe auf der Qualcomm NPU in nur 3ms ausgeführt. Die erzielte Beschleunigung eröffnet neue Möglichkeiten für Deep-Learning-Anwendungen auf Embedded-Plattformen, z.B. in der Inline-Qualitätskontrolle bei hohen Taktraten.