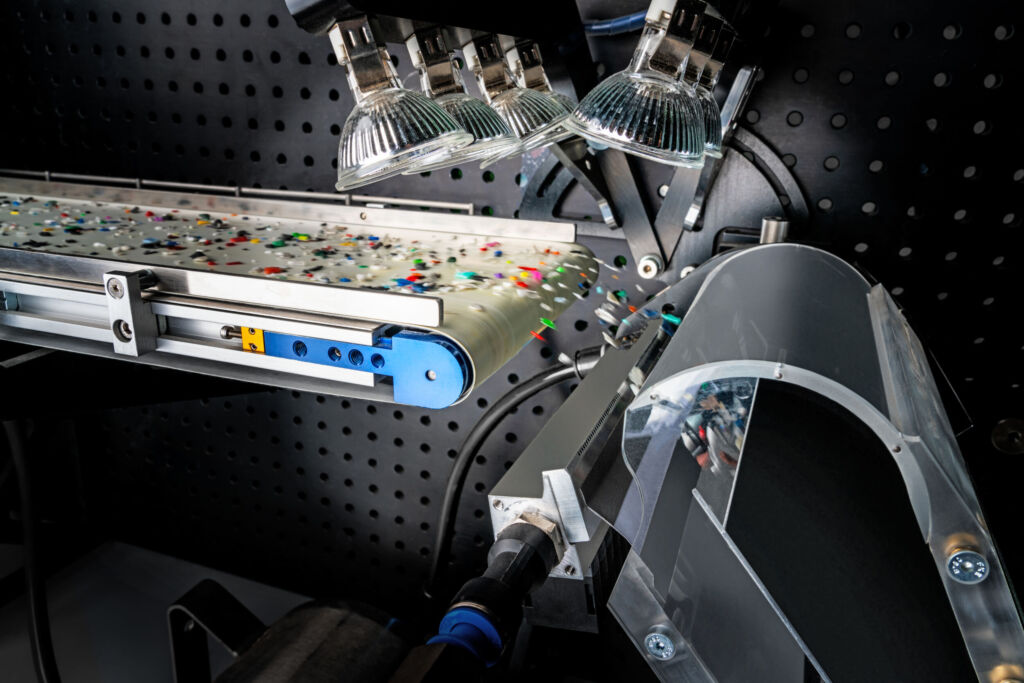
Zeilenkameras sind aus der industriellen Inspektion nicht wegzudenken, denn sie entkoppeln die Ortsauflösung von Objektgrößen und Transportgeschwindigkeit. Ein besonders anspruchsvolles Einsatzgebiet ist die sensorgestützte Sortierung, an der die Gruppe Sensorgestützte Sortiersysteme am Fraunhofer IOSB forscht. Schüttgut wird auf einem Förderband oder einer Rutsche erfasst, klassifiziert und gezielt mittels physikalischer Aktoren, in der Regel Druckluftventile, ausgeschleust. Aus dem Abstand zwischen Kamerazeile und Düsenleiste und der Materialgeschwindigkeit ergibt sich ein fest vorgegebenes Latenzbudget, typischerweise im Bereich einiger Millisekunden. Kommt die Sortierentscheidung zu spät, ist das Objekt bereits an der Düsenleiste vorbei. Wenn Bildzeilen verloren gehen, bleiben Objekte unerkannt. Es besteht ein hartes Echtzeitproblem. Klassische Bildverarbeitungs-Verfahren wie die Zusammenhangsanalyse sind für diesen zeilenweisen Datenstrom optimiert. CNNs, etwa für die semantische Segmentierung, nutzen dagegen gelernte Filter-Kernel, um die räumliche Nachbarschaft von Pixeln zu erfassen und sind damit für komplexe Prüfaufgaben attraktiv. Allerdings verarbeiten sie 2D-Bilder und keine einzelnen Zeilen. Vor jeder Inferenz müssen N Zeilen gebuffert werden, was Latenz kostet und zum Durchsatzengpass werden kann.
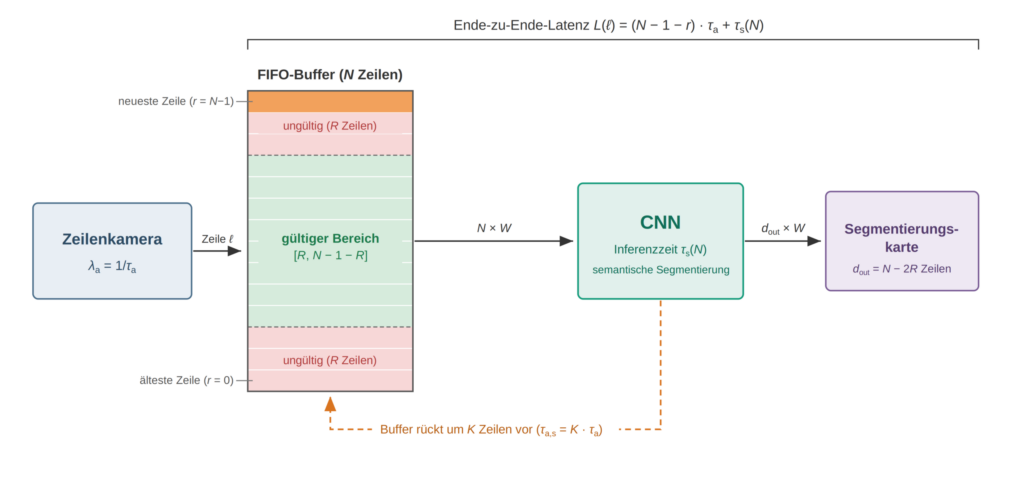
Zeilenbuffer, Vorschub & rezeptives Feld
Das am Fraunhofer IOSB entwickelte Systemmodell beschreibt diese Verarbeitungskette formal. Die Zeilenkamera füllt einen FIFO-Buffer mit N Zeilen, nach jeder Inferenz rückt er um K neu eingetroffene Zeilen vor. Daraus ergeben sich mehrere Schlussfolgerungen. Erstens die Latenz: Die älteste Zeile im Buffer wartet im ungünstigsten Fall N-1 Zeilen-Takte plus die Inferenzzeit. Zweitens die Stabilität: Eine Inferenz muss mit der Zeilenrate Schritt halten, d.h., sie muss abgeschlossen sein, bevor K neue Zeilen eingetroffen sind. Ansonsten läuft der Buffer über und Bilddaten gehen verloren. Timing-Jitter und thermische Effekte machen eine Sicherheitsreserve nötig, die Auslastung sollte daher 70 bis 80 Prozent nicht übersteigen. Drittens das rezeptive Feld: An den Bufferrändern fehlt dem Netz Kontext, dadurch sind nur Ergebnisse im inneren Bereich gültig. Beidseitig werden R Randzeilen ausgespart, wobei sich R als halbe Breite des rezeptiven Felds aus Kernelgrößen und Strides ergibt. Der Buffer muss also mindestens 2R+1 Zeilen umfassen und K darf die Zahl gültiger Ausgabezeilen N-2R nicht übersteigen, sonst entstehen Lücken im Ergebnis. Daraus ergibt sich ein Auslegungsverfahren für den Einsatz von CNNs für Zeilensensoren in fünf Schritten:
- Bestimmung von R aus der Netzarchitektur.
- Die Inferenzzeit auf der Zielhardware messen (als Worst-Case-Größe dient das 99. Perzentil).
- Für jede Buffergröße den kleinsten stabilen Vorschub K berechnen und alle Buffergrößen verwerfen, bei denen K keine lückenlose Ausgabe mehr zulässt.
- Das Latenzbudget der Anwendung prüfen.
- Das Parameterpaar mit der geringsten Latenz wählen.
Bleibt keine Lösung übrig, ist die Kombination aus Netz und Hardware nicht echtzeitfähig. Mithilfe des Vorgehens ist dies einfach vor der Inbetriebnahme zu überprüfen. Zudem lässt sich die gewählte Parameterwahl bzgl. ihrer Effizienz und Auslastung so einordnen.
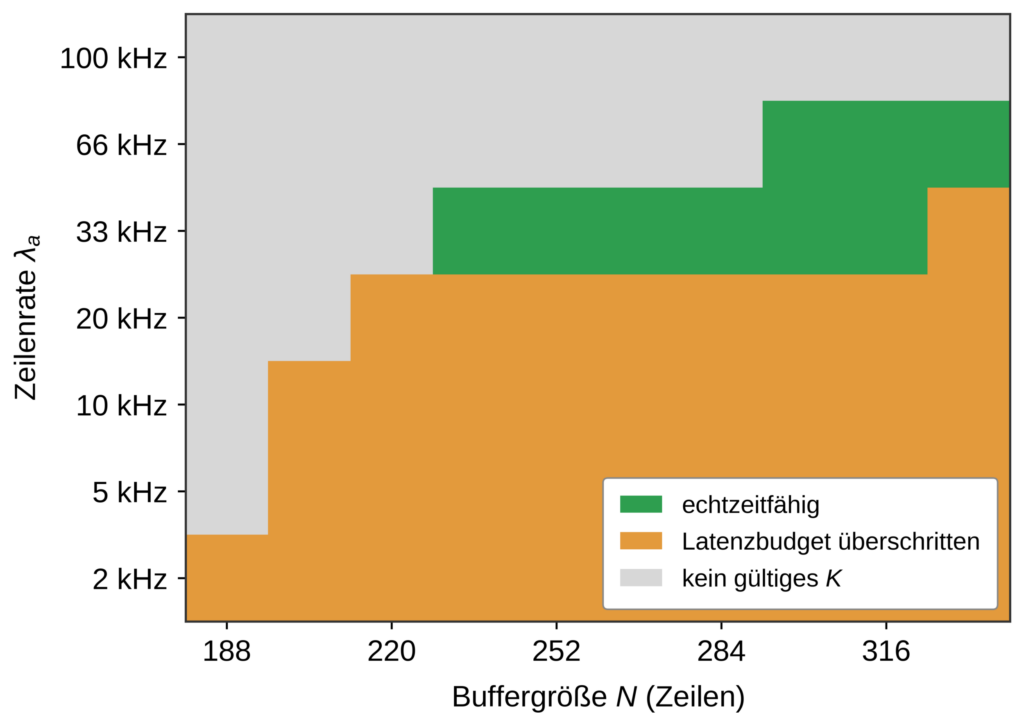
Fallstudie: U-Net auf TensorRT
Validiert wurde das Modell mit einem U-Net ohne Padding (R=92 Zeilen, 512 Pixel Zeilenbreite), kompiliert mit TensorRT 10.1 in FP32 auf einer Nvidia RTX 2070. Die Inferenzzeit steigt linear von 0,98ms bei 188 auf 1,85ms bei 332 Bufferzeilen. Bei einem Latenzbudget von 15ms ist das System bei 33kHz für Buffergrößen von 236 bis 316 Zeilen und bei 66kHz ab 300 Zeilen echtzeitfähig. Bei 20kHz und darunter kann das Latenzbudget nicht eingehalten werden. Langsame Kameras brauchen schlicht länger, um den Buffer zu füllen (bei 10kHz dauern schon 188 Zeilen knapp 19ms). Mit 50ms Budget sind 10 und 20kHz machbar, erst bei 5kHz reicht auch das nicht mehr. Bei schnellen Kameras ist nicht die Inferenzzeit das Problem, sondern die Deckung. Pro Inferenz treffen so viele neue Zeilen ein, dass ein kleiner Buffer nicht genug gültige Ausgabezeilen liefert, um sie lückenlos abzudecken.
Zeilenweise Inferenz
Zwischen zwei Inferenzläufen sind N-K Bufferzeilen identisch und werden dennoch jedes Mal neu berechnet. Das lässt sich vermeiden: Bei der entwickelten zeilenweisen Inferenz liegen die Feature-Maps jeder Netzschicht in einem Cache und werden beim Vorschub um K Zeilen verschoben. Neu berechnet wird nur der Streifen der K neu eingetroffenen Zeilen. Die Ergebnisse im gültigen Bereich sind numerisch äquivalent zur vollständigen Inferenz, die gemessene Abweichung liegt unter 5×10⁻⁸. Theoretisch sinkt der Rechenaufwand um den Faktor N/K, in der Praxis begrenzt die Architektur den Gewinn: Wegen der vier Pooling-Layer benötigt das U-Net mindestens 188 Zeilen als Input, die Obergrenze liegt damit bei rund N/(2R+1) statt bei N/K. Gemessen wurde eine bis zu 1,9-fache Beschleunigung gegenüber der vollständigen Inferenz des gesamten Buffers, ein synthetisches Netz ohne Pooling erreicht sogar den Faktor 13,6. Erfasst ist dabei nur der Rechenaufwand eines Aktualisierungsschritts, das Verschieben der Caches kommt in einer fusionierten Implementierung hinzu, die Werte sind also Obergrenzen.
Fazit
Die zeilenweise Inferenz lohnt sich, wenn der Buffer deutlich größer als das rezeptive Feld ist und ein kompilierendes Backend wie TensorRT zum Einsatz kommt. Für latenzkritische Anwendungen empfehlen sich sehr kleine Vorschübe (K=1 oder 2), für maximale Recheneffizienz größere (K=32 oder 64). Mehr als die architekturbedingte Obergrenze erreicht nur ein anderes Backbone. Für Inspektionssysteme heißt das, Netze von Beginn an für den Betrieb mit Zeilensensoren zu entwerfen. Gerade in der sensorgestützten Sortierung lohnt diese Betrachtung, da hier Deep-Learning-Verfahren komplexe Materialeigenschaften erkennen, die sich mit klassischen Merkmalen nur schwer abbilden lassen, etwa optisch ähnliche Kunststoffe im Recycling oder produktspezifische Fehlerbilder. Mit dem vorgestellten Modell lässt sich bereits in der Planungsphase prüfen, ob ein solches Netz auf der vorgesehenen Hardware echtzeitfähig ist.